Strona główna
» Dzisiaj
»
Co produkuje technologia Micron i dlaczego jej pamięć ma znaczenie dla sztucznej inteligencji
Co produkuje technologia Micron i dlaczego jej pamięć ma znaczenie dla sztucznej inteligencji
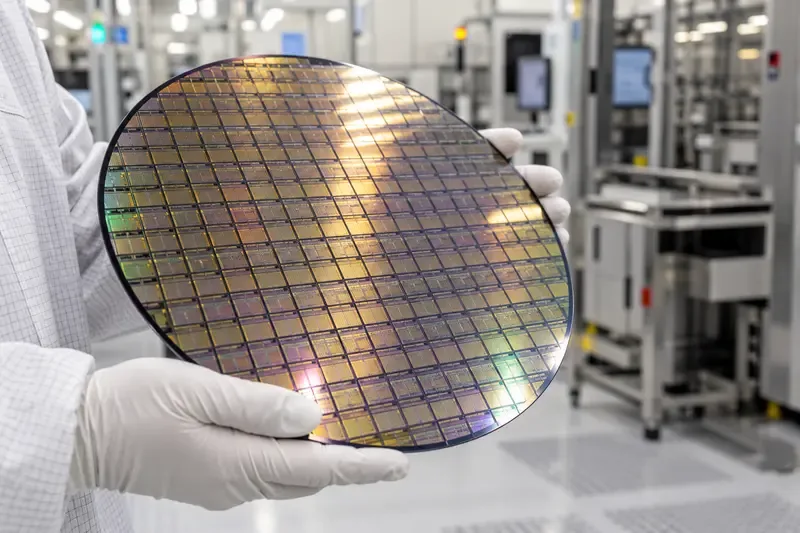
Wzorzysty wafel krzemowy w pomieszczeniu czystym symbolizuje proces produkcji układów pamięci i pamięci masowej.
Micron Technology projektuje i produkuje półprzewodnikowe pamięci i produkty pamięci masowej. Najbardziej znane kategorie firmy to DRAM, NAND flash i NOR flash, wykorzystywane w centrach danych, komputerach PC, telefonach, pojazdach i innych systemach. Jej związek ze sztuczną inteligencją jest szczególnie widoczny w pamięciach o dużej przepustowości (HBM): szybkiej, kompaktowej formie pamięci DRAM umieszczonej blisko wydajnych procesorów, która zapewnia przepływ danych podczas szkolenia i wnioskowania AI.
Pożytecznym wnioskiem jest to, że wydajność sztucznej inteligencji zależy od czegoś więcej niż tylko procesora. Model może działać wydajnie tylko wtedy, gdy dane, parametry modelu i wyniki pośrednie docierają do procesora wystarczająco szybko. Micron dostarcza kilka warstw tej hierarchii pamięci. To, która warstwa jest najważniejsza, zależy od obciążenia, a zakup szybszej pamięci nie rozwiąże wszystkich wąskich gardeł sztucznej inteligencji.
Co produkuje Micron Technology?
Micron to firma produkująca pamięci i pamięci półprzewodnikowe, a nie producent modeli AI ani dostawca usług w chmurze. Zajmuje się projektowaniem i produkcją układów scalonych i modułów, które są wykorzystywane w wielu gałęziach elektroniki i infrastruktury. Portfolio produktów obejmuje:
DRAM: Szybka, tymczasowa pamięć robocza używana przez procesory. Standardowa pamięć DRAM dla serwerów często występuje w postaci modułów DDR5; HBM to specjalistyczna architektura DRAM zoptymalizowana pod kątem bardzo dużej przepustowości.
Pamięć flash NAND: Nieulotna pamięć masowa stosowana w dyskach SSD i innych urządzeniach. Pamięć NAND przechowuje dane po wyłączeniu zasilania, co czyni ją idealną do przechowywania plików modelowych, zestawów danych i punktów kontrolnych.
Pamięć flash NOR: rodzaj pamięci nieulotnej powszechnie stosowanej w przypadku oprogramowania sprzętowego i innego kodu, który musi być odczytywany niezawodnie.
Produkty Micron pełnią różne role i wiążą się z różnymi kompromisami: pamięć robocza jest zaprojektowana z myślą o szybkim dostępie, podczas gdy pamięć masowa zachowuje znacznie większe wolumeny informacji przy niższym koszcie na bit, ale zazwyczaj z większym opóźnieniem dostępu. Oficjalny katalog produktów firmy i jej najnowszy formularz 10-K za rok fiskalny 2026 opisują jej działalność w zakresie pamięci i pamięci masowej.
Dlaczego pamięć ma tak duże znaczenie dla sztucznej inteligencji?
Akceleratory AI wykonują dużą liczbę obliczeń, ale obliczenia te wymagają danych. Podczas trenowania modelu system wielokrotnie odczytuje wagi modelu i przykłady treningowe, a następnie zapisuje wyniki pośrednie. Podczas wnioskowania odczytuje wagi i przetwarza każde żądanie użytkownika, zachowując jednocześnie kontekst i inne dane tymczasowe. Jeśli dane docierają wolniej, niż procesor jest w stanie je wykorzystać, procesor traci czas na oczekiwanie.
Pamięć ma zatem kilka praktycznych ograniczeń: ile danych może pozostać w pobliżu procesora, jak szybko mogą być one dostarczane, ile żądań można jednocześnie zrealizować oraz ile energii system zużywa na przesyłanie tych danych. Większa przepustowość pamięci może pomóc w przypadku obciążenia, które ma ograniczenia związane z przesyłaniem danych. Pojemność ma znaczenie, gdy model, kontekst lub partia żądań musi zmieścić się w określonej warstwie pamięci. Żadna z tych opcji nie przyspiesza automatycznie systemu, jeśli czynnik ograniczający leży gdzie indziej.
Gdzie pasują HBM, serwerowa pamięć DRAM i dyski SSD
Pamięć lub magazyn
Typowa rola sztucznej inteligencji
Co oceniać
HBM
Pamięć o bardzo dużej przepustowości, bliska akceleratorowi AI
Pojemność na akcelerator, przepustowość, moc i kompatybilność platformy
Pamięć DRAM serwera DDR5 i inne moduły
Pamięć systemowa dla procesorów i obciążeń serwerów; obsługuje przygotowywanie danych i szersze procesy
Pojemność, opóźnienie, przepustowość, moc i obsługiwany typ modułu
Dyski SSD do centrów danych oparte na technologii NAND
Trwałe przechowywanie zestawów danych, plików modeli, punktów kontrolnych i wybranych zadań obsługi danych
Pojemność, zachowanie odczytu/zapisu, wytrzymałość, opóźnienie i całkowity koszt
HBM powstaje poprzez układanie kości DRAM i łączenie ich za pomocą bardzo szerokiego interfejsu. Jej umiejscowienie obok procesora skraca czas potrzebny na przesłanie danych i umożliwia równoległy ruch wielu bitów. Micron obecnie podaje, że pamięć HBM4 36 GB o wysokości 12 jest produkowana w dużych ilościach i zapewnia przepustowość ponad 2,8 terabajta na sekundę na stos. Są to opublikowane specyfikacje produktów Micron, a nie gwarancja, że każdy serwer AI osiągnie daną prędkość aplikacji. Aktualne portfolio i kwalifikacje można znaleźć w informacjach o produktach HBM firmy.
Serwerowa pamięć DRAM zapewnia większą przestrzeń roboczą dla procesorów i procesów systemowych. Dyski SSD znajdują się niżej w hierarchii: mogą przechowywać znacznie większe zbiory danych i przechowywać je bez zasilania, ale nie zastępują pamięci HBM jako najszybszej pamięci akceleratora. Micron sprzedaje również moduły DRAM o niższym poborze mocy przeznaczone dla centrów danych. Najlepsza równowaga zależy od miejsca, w którym dane oczekują w danym systemie.
Co bieżąca działalność Micron w dziedzinie sztucznej inteligencji mówi czytelnikom?
Raport firmy Micron za rok fiskalny 2026, opublikowany 30 września 2026 roku, opisał rekordowe wyniki roczne i stwierdził, że popyt w centrach danych napędzany sztuczną inteligencją zwiększa zapotrzebowanie na pamięć i pamięć masową. Z formularza 10-K za 2026 rok wynika, że wzrost popytu przewyższył możliwości branży w zakresie zwiększania podaży, a Micron przesunął część podaży pamięci DRAM w kierunku klientów z centrów danych i chmur hiperskalowych. To pokazuje, jak widoczna jest pozycja Micron w infrastrukturze AI: firma sprzedaje kluczowe komponenty potrzebne producentom platform, a rzeczywista wydajność i popyt nadal zależą od projektu systemu i akceptacji klientów. Głównymi źródłami tych oświadczeń są publikacja wyników firmy z 30 września 2026 roku oraz zgłoszenie do Komisji Papierów Wartościowych i Giełd (SEC) .
Te informacje nie stanowią prognozy, że niedobory lub wysokie ceny będą się utrzymywać w nieskończoność. Sam Micron opisuje branżę pamięci jako branżę cykliczną: podaż, popyt, asortyment produktów i ceny mogą się zmieniać, a budowanie i zwiększanie mocy produkcyjnych wymaga czasu. W swoim zgłoszeniu firma zauważa również, że HBM może wymagać większej pojemności wafli i pomieszczeń czystych na bit niż konwencjonalna pamięć DRAM. Popyt na sztuczną inteligencję może mieć znaczenie komercyjne, podczas gdy firma pozostaje narażona na koszty produkcji, konkurencję, terminy klientów i cykle rynkowe.
Jak stwierdzić, czy wąskim gardłem jest pamięć?
Zespół dokonujący oceny wielkości systemu AI powinien zacząć od obciążenia pracą i mierzonych zachowań, a nie od etykiety produktu. Przydatne wskaźniki obejmują:
Wykorzystanie akceleratora i zatrzymywanie: Niskie wykorzystanie w połączeniu z dowodami na to, że dane nie docierają wystarczająco szybko, może wskazywać na problem z pamięcią lub potokiem danych. Samo niskie wykorzystanie nie dowodzi, że przyczyną jest HBM.
Zajętość pamięci i zdarzenia braku pamięci: Jeśli wagi, kontekst lub równoczesne żądania przekraczają dostępną pojemność, zespoły mogą potrzebować mniejszego modelu, mniejszego rozmiaru partii, partycjonowania lub innej warstwy pamięci.
Przepustowość i opóźnienie: Zmierz liczbę tokenów na sekundę, opóźnienie żądań i przepustowość przy rzeczywistym połączeniu monitów i współbieżności. Porównaj przed i po kontrolowanej zmianie konfiguracji.
Koszty zużycia energii i całkowity koszt systemu: Szybsze komponenty mogą zwiększyć koszty zakupu i eksploatacji. Oceń chłodzenie, moc serwera, sieć, oprogramowanie i pamięć razem.
Jeśli większa przepustowość poprawia zmierzoną przepustowość lub opóźnienie ogonowe przy akceptowalnym koszcie, pamięć prawdopodobnie stanowiła istotne ograniczenie. Jeśli ta sama aktualizacja niewiele zmienia, należy zbadać limity obliczeniowe, wydajność jądra, komunikację między akceleratorami, ładowanie danych, harmonogramowanie oprogramowania oraz zasilanie i chłodzenie. To sprawdzenie pomaga uniknąć płacenia za pojemność, której obciążenie nie może wykorzystać.
Co powinni porównać kupujący przed wyborem konfiguracji pamięci AI?
Porównaj całą platformę, a nie specyfikacje pamięci osobno. Sprawdź, ile pamięci HBM jest dostępne dla każdego akceleratora, czy model docelowy i kontekst są dopasowane, obsługiwane generowanie pamięci, pojemność DRAM serwera, zachowanie dysków SSD dla zadań pamięci masowej oraz szczegóły dotyczące dostaw i kwalifikacji dostawcy. Następnie przeprowadź analizę porównawczą obciążenia, które zamierzasz uruchomić, uwzględniając realistyczną współbieżność i rozmiary danych.
Micron ma znaczenie, ponieważ pamięć stanowi fundament infrastruktury AI, a jego portfolio obejmuje wiele warstw, od pamięci HBM (Hardware Management System), przez serwerową pamięć DRAM, po dyski SSD. Nie oznacza to jednak, że każde wdrożenie AI wymaga najbardziej zaawansowanej pamięci ani że jeden dostawca decyduje o wydajności systemu. Efektem jest konfiguracja, która spełnia wymagania modelu dotyczące pojemności i przepustowości w ramach limitów mocy, dostępności i kosztów. Zmień projekt, gdy pomiary wskazują na inne ograniczenia – a nie tylko dlatego, że istnieje nowsza generacja pamięci.