Ustaw publiczny adres URL NextCloud, aby mógł się do siebie dodzwonić
Napraw ostrzeżenie Nextcloud o brakującym adresie wychodzącym, ustawiając jego kanoniczny adres URL i sprawdzając routing DNS, HTTPS i odwrotnego serwera proxy na samym serwerze.
Jeśli system SUSE Linux Enterprise Server zawiesza się podczas wyłączania systemu systemd, zidentyfikuj jednostkę z uruchomionym zadaniem zatrzymania lub sprawdź ostatnie komunikaty z poprzedniego rozruchu, a następnie napraw tę jednostkę lub jej zależności. Jednostka to zasób zarządzany przez systemd, taki jak usługa lub punkt montowania; zadanie zatrzymania to żądanie systemu systemd o jego zamknięcie. Nie obniżaj globalnego limitu czasu ani nie wymuszaj wyłączenia zasilania jako pierwszej metody naprawy, ponieważ usługa lub system plików może nadal zamykać pliki lub zapisywać dane.
Niniejszy przewodnik jest oparty na dokumentacji SLES 15 SP7 sprawdzonej w październiku 2026 r. Dokładna polityka zatrzymywania zależy od dostawcy usługi i magazynu, dlatego należy korzystać z jego wskazówek w przypadku wszelkich zmian specyficznych dla danej jednostki.
Jeśli w konsoli pojawi się komunikat „Zadanie zatrzymania jest uruchomione dla…” z odliczaniem, zapisz nazwę usługi lub montowania oraz informację o zmianie timera. Oznacza to, że systemd oczekuje na operację zatrzymania danej jednostki, a niekoniecznie na awarię systemu operacyjnego; bazy danych i zdalne magazyny danych mogą potrzebować czasu na prawidłowe zamknięcie.
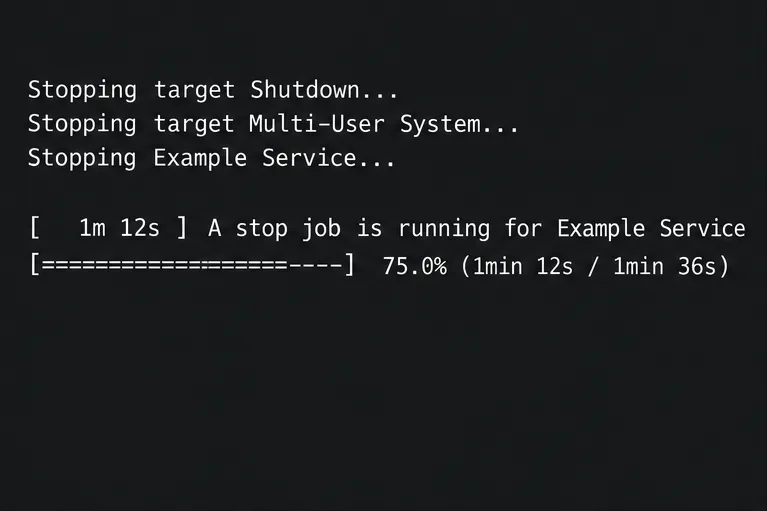
Obserwuj za pomocą konsoli zdalnej lub szeregowej albo innego dostępnego terminala. Unikaj poleceń resetowania i zasilania podczas operacji zapisu. Jeśli system przestanie reagować, zapisz ostatnią widoczną linię i kontynuuj po uruchomieniu.
Jeśli SSH lub drugi terminal nadal działa, zapytaj systemd, które zadania są uruchomione lub oczekujące, a następnie sprawdź nazwę jednostki na ekranie:
sudo systemctl list-jobs
sudo systemctl status SERVICE.service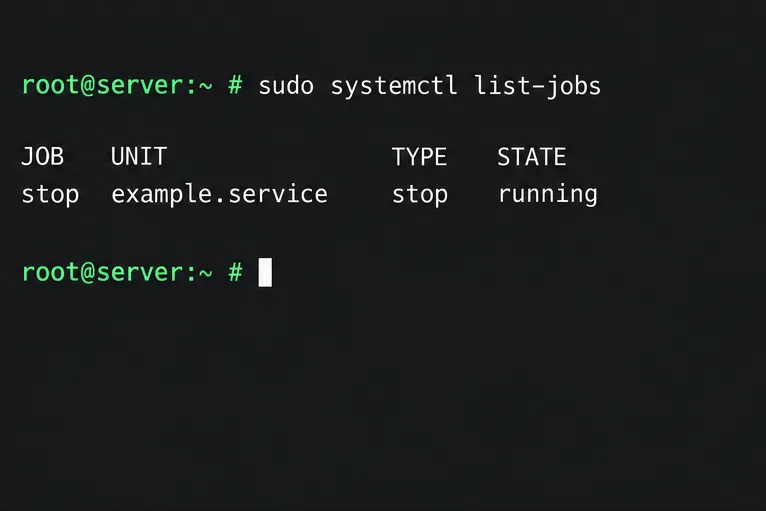
Zastąp SERVICErzeczywistą nazwą jednostki. Uruchomione zadanie zatrzymania zawęża zakres wyszukiwania, ale nie wyjaśnia, dlaczego proces nie został zakończony. Przed zmianą konfiguracji zapoznaj się z jego statusem i dziennikami. Jeśli systemd nie odpowiada, nie anuluj zadań bezmyślnie; sprawdź poprzedni dziennik po powrocie hosta.
Dziennik to indeksowany dziennik systemd zawierający komunikaty jądra, usług i systemu. Po kolejnym pomyślnym uruchomieniu wyświetl listę zarejestrowanych rozruchów i sprawdź zakończenie poprzedniego:
sudo journalctl --list-boots
sudo journalctl -b -1 -e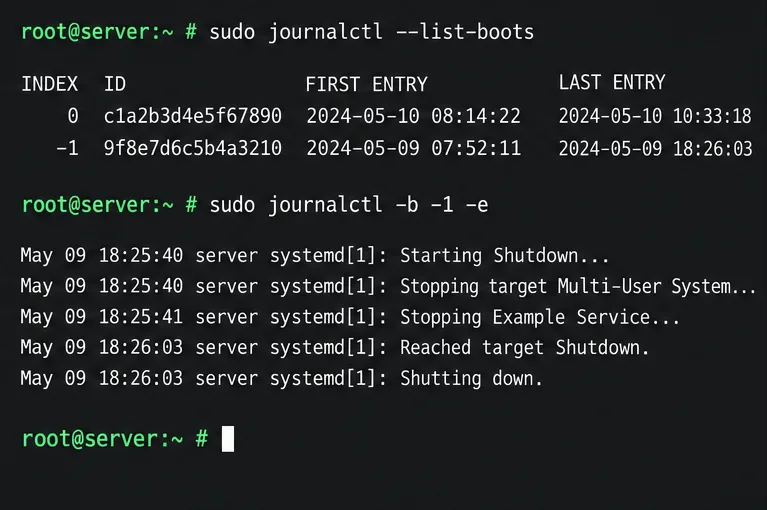
-1powoduje wybranie poprzedniego rozruchu i -eprzejście do jego najnowszych wpisów.Poszukaj ostatniego komunikatu „Stopping”, przekroczenia limitu czasu, ponownych prób lub nazwanego urządzenia lub montażu. Ostatni wiersz to tylko wskazówka: polecenie wyłączenia może pozostawić inną jednostkę oczekującą. Porównaj znaczniki czasu i komunikaty w pobliżu.
Gdy ekran lub dziennik nazwie usługę, zapytaj tylko o poprzednie wpisy rozruchowe tej jednostki. Sprawdź również jej załadowaną konfigurację:
sudo journalctl -b -1 -u SERVICE.service --no-pager
sudo systemctl cat SERVICE.service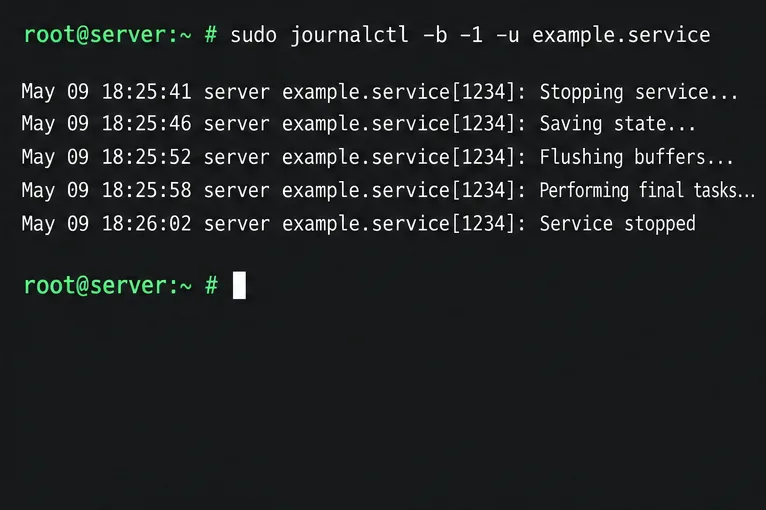
Sprawdź, czy ExecStopw haku zamykania nie występuje niestandardowy plik wykonywalny, skrypt, który czeka w nieskończoność, zawieszony proces potomny lub błąd aplikacji. W przypadku jednostek dostawcy, przed edycją porównaj pakiet i konfigurację z obsługiwanymi wytycznymi.
Jeżeli dziennik wymienia punkt montowania, urządzenie lub zdalny system plików, sprawdź tabelę montowania i odpowiadający jej wpis w /etc/fstab:
sudo findmnt --verify --verbose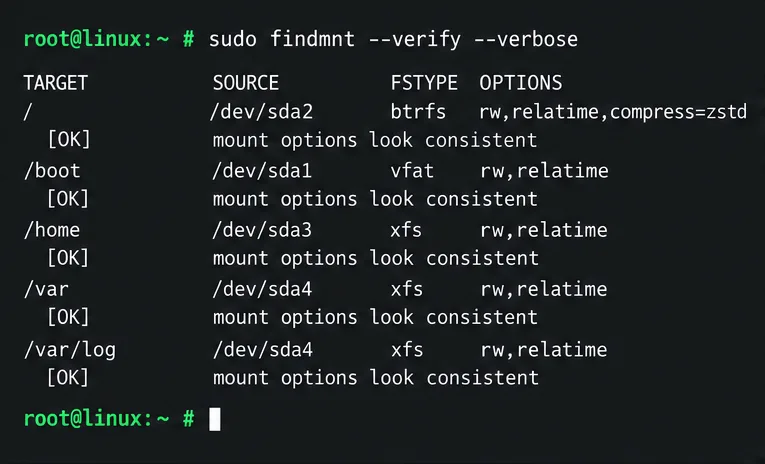
Sprawdź, czy NFS, CIFS, iSCSI lub inna zdalna zależność jest dostępna i oczekiwana podczas zamykania systemu. Usuń przestarzały wpis montowania dopiero po potwierdzeniu, że jest nieużywany. Nie wymuszaj odmontowania aktywnego systemu plików tylko na podstawie powolnego restartu.
W przypadku usługi, która się nie zamyka, należy najpierw naprawić problem ze skryptem zamykającym, konfiguracją aplikacji lub pakietem. Wartość drop-in na jednostkę sudo systemctl edit SERVICE.servicejest przechowywana w /etc/systemd/system/pliku dostawcy bez konieczności edycji pliku. Dokumenty SUSE TimeoutSecdotyczące uruchamiania i zatrzymywania usługi; dla tego obciążenia należy użyć wartości zatwierdzonej przez dostawcę.
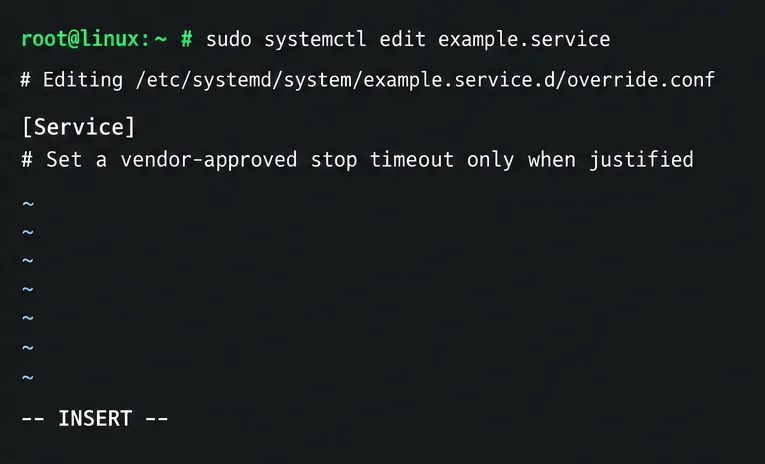
Po udokumentowanej edycji przeładuj definicje jednostek systemd za pomocą sudo systemctl daemon-reloadi sprawdź wynik za pomocą sudo systemctl cat SERVICE.service. Dłuższy limit czasu może pozwolić na prawidłowe zakończenie zamykania systemu, ale może również wydłużyć nieudany restart. Krótszy limit może zakończyć działanie usługi przed opróżnieniem stanu. Nie zmieniaj globalnych ustawień domyślnych, aby ukryć defekt jednej jednostki.
/run/log/journal/SLES domyślnie przechowuje dane dziennika w tym katalogu , a ten katalog zmienny jest czyszczony po ponownym uruchomieniu. Jeśli journalctl -b -1nie ma żadnych wpisów z poprzedniego rozruchu, włącz trwałe przechowywanie dziennika na potrzeby przyszłej diagnostyki:
sudo mkdir -p /var/log/journal
sudo systemd-tmpfiles --create --prefix=/var/log/journal
sudo journalctl --flush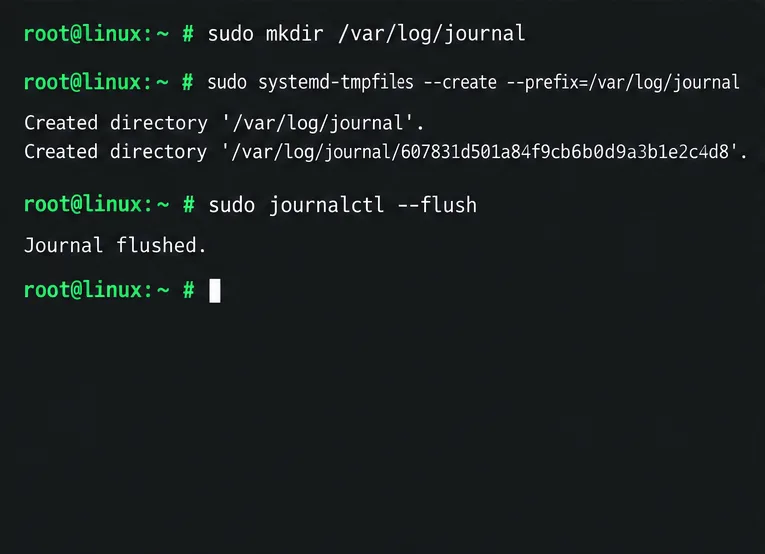
Trwałe logi zajmują przestrzeń w systemie plików /var; SUSE zauważa, że dziennik może domyślnie zajmować do 10 procent tego systemu plików. Sprawdź ilość wolnego miejsca i retencję, szczególnie na małych /varwolumenach.
Po usunięciu podejrzewanej przyczyny zaplanuj jeden kontrolowany restart z dostępem do konsoli. Po powrocie komputera sprawdź ostatnie komunikaty z poprzedniego rozruchu i sprawdź aktualny stan usługi:
sudo journalctl -b -1 -e
sudo systemctl status SERVICE.service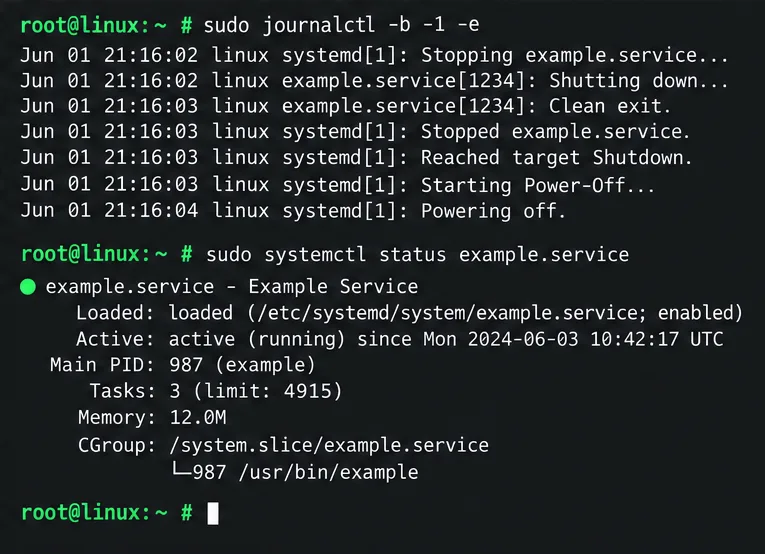
Problem rozwiązuje się, gdy serwer wyłącza się bez oczekiwania na tę samą jednostkę, uruchamia się normalnie, a usługa lub montowanie działa. Jeśli logi nagle się kończą lub wskazują na błędy jądra, kontrolera lub sprzętu, należy je zachować i zbadać problem z pomocą SUSE lub dostawcy sprzętu, zamiast dostrajać limity czasu.
Szczegóły dotyczące poleceń można znaleźć w podręczniku systemd dla systemu SLES 15 SP7 oraz w podręczniku SUSE dotyczącym dzienników trwałych i filtrów journalctl . Te kroki identyfikują prawdopodobne blokady; właściwy sposób rozwiązania problemu z usługą, systemem plików lub sprzętem zależy od jednostki wskazanej w logach komputera.
Napraw ostrzeżenie Nextcloud o brakującym adresie wychodzącym, ustawiając jego kanoniczny adres URL i sprawdzając routing DNS, HTTPS i odwrotnego serwera proxy na samym serwerze.
Skonfiguruj APCu i Redis przez lokalne gniazdo Unix na potrzeby buforowania i blokowania plików w usłudze Nextcloud, wraz z instrukcjami dla bieżących i starszych wersji usługi Nextcloud.
Sprawdź tryb cron Nextcloud, napraw usługę systemd i timer oraz zweryfikuj, czy zadania w tle są uruchamiane po uruchomieniu i co pięć minut.
Włącz niezawodne blokowanie plików Nextcloud, wybierz odpowiedni serwer Redis lub Valkey i sprawdź, czy ostrzeżenie zostanie usunięte bez ryzyka równoczesnych zmian w plikach.
Napraw typowe błędy skanowania Nextcloud dzięki bieżącym aktualizacjom, protokołom HTTPS i HSTS, precyzyjnemu zaufaniu do odwrotnego serwera proxy i sprawdzeniu względem serwera publicznego.
Skonfiguruj Nextcloud SSE dla pamięci masowej, która tego wymaga, chroń klucze szyfrujące i zmierz wpływ transferu i procesora przed zaszyfrowaniem istniejących plików.
Połącz wyszukiwarkę plików Nextcloud z Elasticsearch, zindeksuj zawartość dokumentów i wybierz konfigurację odpowiadającą Twoim potrzebom w zakresie serwera i bezpieczeństwa.
Skonfiguruj Nextcloud tak, aby usuwał usunięte pliki po upływie określonego czasu przechowywania, niezawodnie planował zadania w tle i unikał poleceń, które usuwają śmieci każdego użytkownika.
Wykonaj bezpieczną naprawę OCC w Nextcloud, przejrzyj zmiany w bazie danych i sprawdź, dlaczego ostrzeżenie może nadal się pojawiać.
Zezwól na przesyłanie większych plików przez przeglądarkę Nextcloud, dostosowując ustawienia PHP, Nginx lub Apache, tymczasowego miejsca przechowywania i limitu czasu — i sprawdź, który limit blokuje plik.




