W ostatnich latach, wraz z wybuchem rewolucji przemysłowej 4.0, terminy takie jak sztuczna inteligencja (AI), uczenie maszynowe i głębokie uczenie stopniowo stają się popularne i stają się pojęciami, które obywatele ery 4.0 muszą zrozumieć.
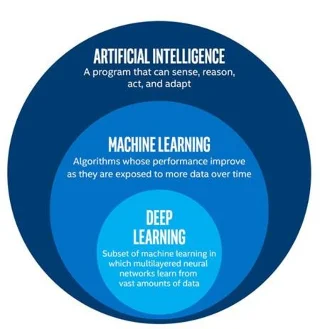
Związek między tymi trzema koncepcjami można wyjaśnić, myśląc o nich jako o kręgach, w których sztuczna inteligencja – najwcześniejszy pomysł – jest największym kręgiem, następnie uczenie maszynowe – koncepcja, która pojawia się później, i wreszcie głębokie uczenie – które napędza obecny Boom AI – to najmniejsze koło.
Budowanie systemu AI jest oczywiście niezwykle skomplikowane, ale zrozumienie go nie jest takie trudne. Większość obecnych sztucznych inteligencji to po prostu naprawdę dobre maszyny do zgadywania (podobne do naszych mózgów). Dajesz systemowi grupę danych (takich jak cyfry od 1 do 10) i prosisz system o utworzenie modelu (x + 1, zaczynając od 0) i wykonanie prognoz. (Następna liczba to jedenaście). Nie ma magii, to właśnie robi ludzki mózg na co dzień: wykorzystujemy to, co wiemy, aby zgadywać nieznane.
Tym, co odróżnia sztuczną inteligencję od innych programów komputerowych, jest to, że zamiast tworzyć określone programy dla każdego przypadku, możemy całkowicie uczyć AI (uczenie maszynowe), a także ma możliwość automatycznego uczenia głębokiego. Te trzy pojęcia można zasadniczo zdefiniować w następujący sposób:
Sztuczna inteligencja (AI): maszyna, która może naśladować ludzkie zachowanie i myślenie.
Uczenie maszynowe: funkcja sztucznej inteligencji, która pozwala ekspertom trenować sztuczną inteligencję w zakresie rozpoznawania wzorców danych i przewidywania.
Głębokie uczenie: Mała technika uczenia maszynowego, która umożliwia maszynom samouczenie się.
Co to jest sztuczna inteligencja (sztuczna inteligencja)?

AI można zdefiniować jako gałąź informatyki, która zajmuje się automatyzacją inteligentnych zachowań. Sztuczna inteligencja jest częścią informatyki i dlatego musi opierać się na zdrowych, możliwych do zastosowania teoretycznych zasadach tej dziedziny. Mówiąc najprościej: to inteligencja maszyn tworzonych przez ludzi. Ta inteligencja może myśleć, myśleć, uczyć się... jak inteligencja ludzka. Przetwarzaj dane na większą, większą skalę, systematycznie, naukowo i szybciej niż ludzie.
Jednak obecnie technologia AI jest nadal bardzo ograniczona. Na przykład Alexa – świetna gospodyni, jedna z najpopularniejszych ikon aplikacji sztucznej inteligencji, ale wciąż nie może zdać testu Turinga.
Krótko mówiąc, to, co robimy dzisiaj z AI, to koncepcja „wąskiej sztucznej inteligencji”. Ta technologia jest w stanie wykonywać określone zadania w podobny sposób lub lepiej niż ludzie. Przykłady „wąskiej sztucznej inteligencji” w praktyce obejmują technologię klasyfikacji obrazów Pinteresta lub rozpoznawanie twarzy do oznaczania znajomych na Facebooku.
Technologie te reprezentują pewien aspekt ludzkiej inteligencji, ale jak to możliwe? Skąd pochodzi ta mądrość? Przejdźmy do kolejnego kręgu: uczenie maszynowe.
Co to jest uczenie maszynowe?

Uczenie maszynowe – podejście AI
Uczenie maszynowe to szerokie pojęcie, które odnosi się do czynności polegającej na nauczeniu komputera, aby usprawnić wykonywane przez niego zadanie. Dokładniej, uczenie maszynowe odnosi się do każdego systemu, w którym wydajność komputera podczas wykonywania zadania poprawia się po wielokrotnym wykonaniu tego zadania. Innymi słowy, najbardziej podstawową umiejętnością uczenia maszynowego jest wykorzystanie algorytmu do analizy dostępnych informacji, uczenia się na ich podstawie, a następnie podejmowania decyzji lub przewidywania czegoś z nimi związanego. Zamiast tworzyć oprogramowanie ze szczegółowymi instrukcjami i czynnościami do wykonania określonego zadania, komputery są „szkolone” przy użyciu dużych ilości danych i algorytmów, aby nauczyć się, jak wykonać zadanie.
Bez uczenia maszynowego obecna sztuczna inteligencja byłaby dość ograniczona, ponieważ daje komputerom możliwość rozwiązywania problemów bez wyraźnego programowania. Jako przykład typu uczenia maszynowego powiedzmy, że chcesz, aby program był w stanie identyfikować koty na zdjęciach:
- Najpierw dajesz sztucznej inteligencji zestaw cech kota, które maszyna może rozpoznać, takich jak kolor sierści, kształt ciała, rozmiar itp.
- Następnie przekazujesz niektóre obrazy do sztucznej inteligencji, gdzie niektóre lub wszystkie obrazy mogą być oznaczone etykietą „kot”, dzięki czemu maszyna może skuteczniej wybierać funkcje i szczegóły związane z kotem.
- Po otrzymaniu przez maszynę wszystkich niezbędnych danych o kotu, musi wiedzieć, jak znaleźć kota na zdjęciu – „Jeśli obraz zawiera pewne szczegóły X, Y lub Z, istnieje 95% szansa na znalezienie kota na zdjęciu .Może to kot."
Ogólnie rzecz biorąc, dzisiejsze zastosowanie uczenia maszynowego jest niezwykle popularne, a jego użyteczność jest niekwestionowana.
Co to jest głębokie uczenie się?

Deep Learning – technika uczenia maszynowego
Można powiedzieć, że do tej pory sztuczna inteligencja osiągnęła wiele wspaniałych postępów. Pomyśl o tym jako o rodzaju uczenia maszynowego z głębokimi „sieciami neuronowymi”, które mogą przetwarzać dane w podobny sposób, jak ludzki mózg. Główna różnica polega na tym, że ludzie nie będą musieli uczyć programu głębokiego uczenia się, jak wygląda kot, ale po prostu daj mu wszystkie niezbędne zdjęcia kotów, a sam to rozwiąże. Kroki, które należy wykonać, są następujące:
- Daj maszynie dużo zdjęć kotów.
- Algorytm sprawdzi obraz, aby zobaczyć wspólne cechy i szczegóły między obrazami.
- Każdy obraz będzie szczegółowo dekodowany na wielu poziomach, od dużych, ogólnych kształtów po coraz mniejsze kafelki. Jeśli kształt lub linie powtarzają się wiele razy, algorytm oznaczy je jako ważną właściwość.
- Po przeanalizowaniu wystarczającej liczby niezbędnych obrazów algorytm wie, które wzorce dostarczają najsilniejszych dowodów na obecność kotów, a ludzie muszą jedynie dostarczyć surowe dane.
W skrócie: głębokie uczenie to rodzaj uczenia maszynowego, w którym maszyna sama się uczy. Głębokie uczenie wymaga o wiele więcej danych wejściowych i mocy obliczeniowej niż uczenie maszynowe, ale już zaczęło być wdrażane przez duże firmy technologiczne, takie jak Facebook i Amazon. Wśród nich jednym z najbardziej znanych nazwisk w uczeniu maszynowym jest AlphaGo, komputer, który może grać w Go przeciwko sobie, aż będzie w stanie przewidzieć najdokładniejsze ruchy na tyle, by pokonać wielu mistrzów świata.
Wyciągnąć wniosek
Głębokie uczenie umożliwiło zastosowanie wielu prawdziwych problemów maszynowych, jednocześnie rozszerzając ogólne pole sztucznej inteligencji. Głębokie uczenie zaburza sposób, w jaki ludzie pracują, sprawiając, że wszystkie rodzaje maszyn wspomagających działają, są zbliżone lub identyczne z ludźmi. Samochody bez kierowcy, lepsza opieka zdrowotna… Wszystko to realizuje się w dzisiejszych czasach. AI to teraźniejszość i przyszłość świata. Za pomocą głębokiego uczenia sztuczna inteligencja może zrealizować marzenie science fiction, które wyobrażaliśmy sobie od dawna.