Strona główna
» Jak
»
Śledź nieudany eksport pliku PDF ONLYOFFICE do źródła
Śledź nieudany eksport pliku PDF ONLYOFFICE do źródła
Najpierw zapisz dokument źródłowy, a następnie sprawdź, czy błąd wystąpił w konwersji PDF w ONLYOFFICE, czy w ostatecznym pobraniu przez przeglądarkę. Jeśli edytor zgłosi błąd konwersji, sprawdź logi serwera dokumentów i upewnij się, że serwer może uzyskać dostęp do pliku źródłowego. Jeśli konwersja się powiedzie, ale przeglądarka wyświetli komunikat „Pobieranie nie powiodło się”, sprawdź stan pobierania, uprawnienia witryny i ilość dostępnego miejsca na dysku.
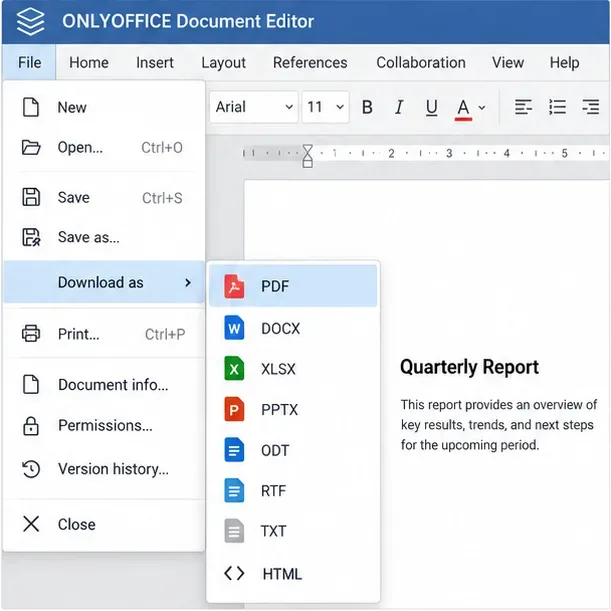
Przykładowy scenariusz: Wyobraź sobie Jordana, administratora korzystającego z samodzielnie hostowanego edytora dokumentów ONLYOFFICE, który wybiera Plik > Pobierz jako > PDF w celu utworzenia raportu projektu. Edytor wyświetla komunikat o błędzie i nie pojawia się żaden plik PDF. To hipotetyczny przykład, a nie przetestowany incydent; ten sam objaw może występować na różnych etapach, dlatego poniższe kontrole są przeprowadzane w momencie zatrzymania procesu.
W menu Plik edytora online dostępne są opcje Pobierz jako oraz format PDF; obraz przedstawia przykładowy widok interfejsu.
1. Zabezpiecz źródło i odtwórz awarię raz
Przed rozpoczęciem rozwiązywania problemów użyj opcji Zapisz lub Ctrl+S, aby zapisać bieżące zmiany. W Edytorze Dokumentów online, ONLYOFFICE dokumentuje ścieżkę eksportu PDF jako Plik > Pobierz jako > PDF. Edytor może najpierw przygotować plik PDF, a następnie przesłać wynik do przeglądarki, więc nieudane pobranie przez przeglądarkę nie zawsze oznacza niepowodzenie samej konwersji.
Użyj tego samego raportu, aby wykonać jedną kontrolowaną ponowną próbę. Zwróć uwagę, czy edytor wyświetla okno dialogowe błędu, czy przeglądarka tworzy wpis o nieudanym pobieraniu i czy problem dotyczy tylko tego pliku, czy wszystkich plików. Unikaj wielokrotnego klikania opcji Eksportuj: zduplikowane zadania utrudniają dopasowanie znacznika czasu do odpowiedniego wpisu w dzienniku serwera.
2. Jeśli przeglądarka wyświetla komunikat o nieudanym pobieraniu pliku PDF
Otwórz stronę Pobieranie w przeglądarce i sprawdź element, który nie został pobrany. Spróbuj ponownie. Sprawdź, czy przeglądarka zablokowała pobieranie z witryny ONLYOFFICE, czy potwierdzenie pobrania czeka na innej karcie i czy na dysku docelowym jest wystarczająco dużo wolnego miejsca. Jeśli zarządzasz przeglądarką, przetestuj ten sam zapisany dokument w bieżącej przeglądarce alternatywnej lub w czystym profilu przeglądarki. Jeśli to zadziała, skup się na ustawieniach przeglądarki, rozszerzeniach lub lokalnym oprogramowaniu zabezpieczającym; nie zmieniaj jeszcze konfiguracji serwera dokumentów.
Hipotetyczny przypadek Jordana wskazywałby na przeglądarkę, gdy edytor zakończy przygotowywanie pliku PDF, ale lista pobierania zgłasza błąd sieci lub brak uprawnień. Praktycznym rozwiązaniem awaryjnym jest skorzystanie z menu Plik > Drukuj i wybranie opcji „Zapisz do PDF” w przeglądarce lub systemie operacyjnym, jeśli jest dostępna. Sprawdź strony, czcionki i linki, ponieważ wydruk może różnić się od bezpośredniego eksportu PDF z edytora. To obejście problemu nie naprawia błędu konwersji po stronie serwera.
Wpis przeglądarki informujący o niepowodzeniu pobierania wskazuje na ostatni etap transferu; spróbuj ponownie i sprawdź uprawnienia pobierania w przeglądarce.
3. Jeśli konwersja lub pobranie źródła nie powiedzie się
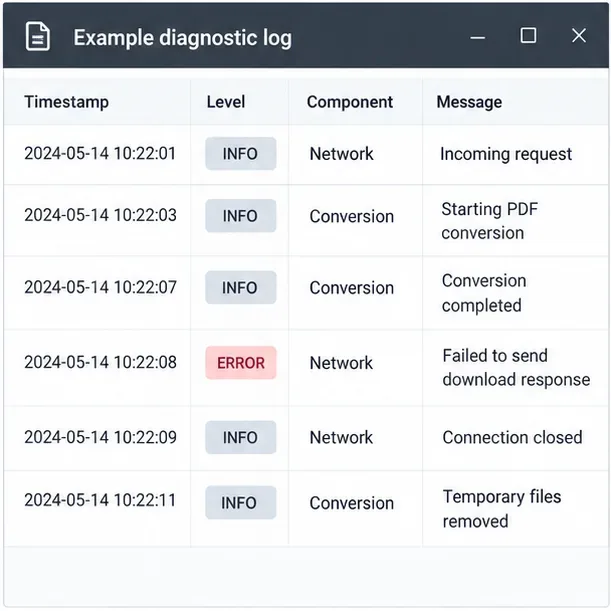
W przypadku instalacji hostowanej samodzielnie, poproś administratora o sprawdzenie logów serwera dokumentów w momencie ponawiania próby. ONLYOFFICE dokumentuje logi Linuksa w /var/log/onlyoffice/documentserver; w przypadku Dockera logi są dostępne w kontenerze w tej ścieżce, a dane wyjściowe Dockera można również sprawdzić za pomocą docker logs <container>. Dokładny opis komponentu i logu zależy od instalacji i wersji. Sprawdź błędy konwersji, przekroczenia limitu czasu, nieudane żądania, kody stanu HTTP lub błędy DNS i połączenia. Nie publikuj pełnych wierszy logu, jeśli zawierają prywatne adresy URL, tokeny dostępu, nazwy użytkowników lub nazwy dokumentów.
Gdy logi lub interfejs API zidentyfikują problem z pobieraniem ze źródła, należy sprawdzić, czy Serwer Dokumentów może dotrzeć do adresu URL dokumentu źródłowego z własnej przestrzeni nazw sieciowych. Administrator może przetestować autoryzowany adres URL z serwera lub kontenera i sprawdzić DNS, routing, reguły zapory sieciowej, ustawienia proxy, certyfikaty TLS oraz odpowiedź aplikacji pamięci masowej. Adres URL otwierany w przeglądarce na komputerze może nadal być niedostępny z Serwera Dokumentów. I odwrotnie, jeśli pobieranie ze źródła przebiegnie pomyślnie, ale konwersja się nie powiedzie, należy zbadać błąd konwertera, zamiast zmieniać dostęp do sieci.
W przypadku przepływów pracy konwersji opartych na API, użyj zwróconego kodu błędu, aby zawęzić problem. ONLYOFFICE definiuje błąd konwersji -4jako błąd pobierania pliku wejściowego, -2przekroczenie limitu czasu, -3błąd konwersji i -8nieprawidłowy token. Kody te są specyficzne dla odpowiedzi API konwersji; ogólny komunikat „Pobieranie nie powiodło się” w edytorze sam w sobie nie dowodzi, że konwersja PDF zwróciła któryś z nich.
Ilustrujący układ dziennika: powiąż błąd sieciowy lub konwersji z czasem nieudanego eksportu; rzeczywiste pola dziennika mogą się różnić.
4. Sprawdź dostęp, uprawnienia i rozmiar tylko wtedy, gdy dowody na to wskazują
Jeśli awaria dotyczy tylko plików przechowywanych na jednej połączonej platformie, należy sprawdzić adres serwera dokumentów i wewnętrzne ustawienia dostępu łącznika. Usługa edycji musi mieć możliwość pobrania pliku z systemu pamięci masowej. Dokumentacja rozwiązywania problemów ONLYOFFICE opisuje komunikat „Niepowodzenie pobierania” podczas ładowania edytora, ponieważ usługa edycji nie może uzyskać dostępu do adresu URL pliku. Ta wskazówka jest przydatna, gdy nie można otworzyć lub załadować raportu; jeśli edytor otwiera się normalnie, a tylko eksport do pliku PDF kończy się niepowodzeniem, najpierw należy sprawdzić etap eksportu lub pobierania.
Jeśli API zgłosi nieprawidłowy token, porównaj konfigurację klucza tajnego, nagłówka i tokenu JWT po obu stronach. Nie wyłączaj JWT jako skrótu. Jeśli API wskazuje limit rozmiaru, porównaj plik z limitami skonfigurowanymi we wdrożeniu. Duży plik lub nieobsługiwane/uszkodzone źródło mogą wymagać innego rozwiązania; zmiana przeglądarki lub sieci nie naprawi limitu konwersji ani uszkodzonego dokumentu.
Włącz rejestrowanie debugowania tylko wtedy, gdy zwykłe logi nie pokazują, gdzie kończy się żądanie, i wyłącz je po zebraniu niezbędnych dowodów. Dzienniki debugowania mogą zawierać poufne szczegóły żądania. Postępuj zgodnie z instrukcjami ONLYOFFICE dla swojego typu instalacji i udostępnij administratorowi lub zespołowi wsparcia zredagowany fragment dziennika, zamiast ujawniać adresy URL dokumentów lub tokeny.
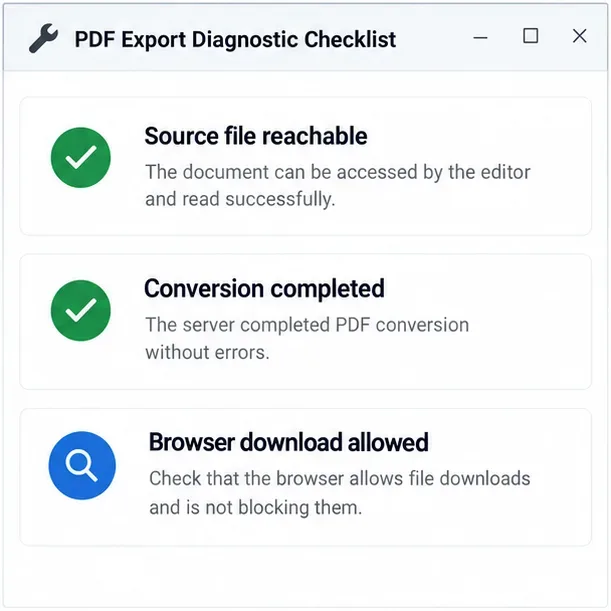
Wykonaj trzy etapy w podanej kolejności: pobranie źródła, konwersja PDF, a następnie pobranie pliku z przeglądarki.
Sprawdź wynik
Sprawdź, czy pobrany plik istnieje, ma rozmiar różny od zera i otwiera się w czytniku PDF.
Sprawdź zgodność pierwszej i ostatniej strony, liczby stron oraz kilku kluczowych czcionek lub obrazów ze źródłem.
Powtórz eksport raz po wprowadzeniu odpowiedniej poprawki. Jeśli problem nadal występuje, zapisz czas, wersję ONLYOFFICE Docs, etap eksportu oraz zredagowany kod błędu lub fragment dziennika.