Najważniejszym wnioskiem płynącym z danych o awariach Salesforce w 2025 roku jest to, że nie wystąpiła pojedyncza, definiująca cały rok „globalna awaria Salesforce”. Zamiast tego klienci doświadczyli kilku różnych wzorców zakłóceń: rozległej przerwy w świadczeniu usług w lutym, błędów uwierzytelniania w wielu chmurach w czerwcu, poważnego incydentu na platformie Heroku spowodowanego niezamierzoną aktualizacją dostawcy, zdarzenia w sieci centrum danych w Indianapolis oraz późniejszych incydentów ograniczonych do konkretnych instancji lub funkcji. To rozróżnienie ma znaczenie, ponieważ właściwa reakcja zależy od tego, co uległo awarii.
Jeśli użytkownicy nie mogą się zalogować, odświeżenie przeglądarki nie rozwiąże problemu. Jeśli publiczna strona stanu jest opóźniona, ogólny monitor awarii może być również niekompletny. Jeśli Salesforce jest dostępny, ale kolejka integracji jest zablokowana, sam system CRM może wyglądać na sprawny, podczas gdy procesy biznesowe nadal zawodzą. Praktyczna lekcja z roku 2025 to połączenie powiadomień o stanie specyficznych dla dzierżawców, niezależnego monitorowania, sprawdzonych procedur ręcznych oraz kontroli odzyskiwania danych dla systemów podrzędnych.
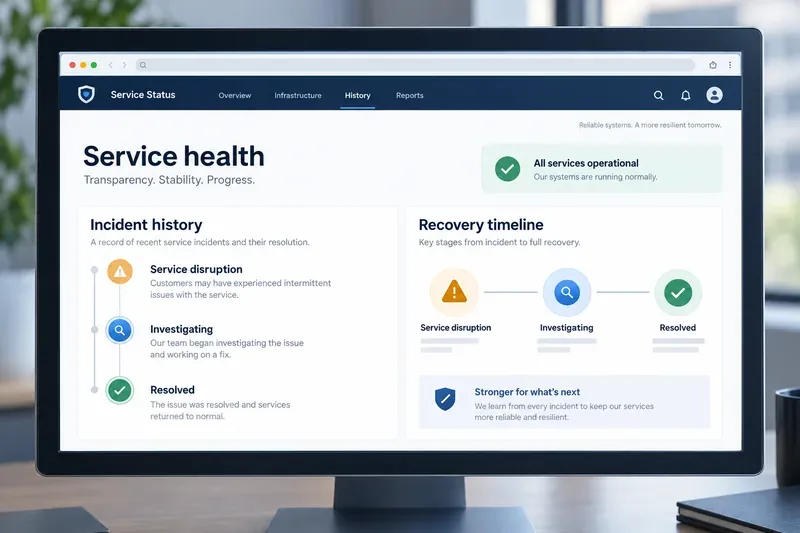
Ogólny panel stanu usługi przedstawia etapy, jakie zespoły analizują podczas rekonstrukcji harmonogramu awarii. Jest to ilustracja koncepcyjna, a nie zrzut ekranu z Salesforce na żywo.
Jakie były największe zakłócenia w Salesforce w 2025 roku?
Poniższe incydenty są przydatne do retrospektywy, ponieważ pokazują różne tryby awarii. Nie oznacza to jednak, że każde zdarzenie dotyczące statusu Salesforce w 2025 roku jest tutaj wymienione.
Data
Zakłócenie
Co pokazuje zapis
Dlaczego to ważne
7 lutego
Zakłócenie usługi
Oficjalny protokół zdarzenia podaje, że zakłócenia zakończyły się o godzinie 11:21 UTC i trwały około 2 godzin i 20 minut.
Szeroko zakrojone zdarzenie serwisowe może mieć wpływ na normalną pracę Salesforce, nawet jeśli jego główna przyczyna nie została publicznie szczegółowo opisana.
10 czerwca
Niepowodzenia uwierzytelniania między chmurami
Firma Salesforce poinformowała o wpływie na usługi uwierzytelniania dla usług Heroku, Commerce, Marketing Cloud i Salesforce.
Zależności logowania i tożsamości mogą spowodować awarię wielu produktów, nawet jeśli każdy z nich nie będzie miał tej samej usterki technicznej.
10 czerwca
Zakłócenie platformy Heroku
Heroku później przypisało incydent niezamierzonej aktualizacji systemu wprowadzonej do infrastruktury produkcyjnej przez dostawcę. Problem dotyczył również witryny Heroku ze statusem.
Kanał komunikacji może stać się częścią incydentu, dlatego niezbędne stają się niezależne ścieżki powiadomień.
18 czerwca
Zakłócenie sieci centrum danych w Indianapolis
Firma Salesforce poinformowała, że awaria systemu chłodzenia w centrum danych w Indianapolis wpłynęła na serwery Stack 1 i 6.
Wydarzenia związane z infrastrukturą fizyczną mogą mieć węższy zakres niż globalna awaria, ale nadal być dotkliwe w kontekście występujących przypadków.
1 listopada
Zakłócenie podstawowej usługi na poziomie instancji
W oficjalnym rejestrze incydentów IND76 jest identyfikowany jako wystąpienie, którego dotyczył problem, a zdarzenie zostaje odnotowane jako rozwiązane.
Sprawdzanie konkretnych instancji jest bardziej przydatne niż poleganie wyłącznie na ogólnych raportach typu „Czy Salesforce nie działa?”.
31 grudnia
Spadek wydajności wiadomości WhatsApp
Firma Salesforce zgłosiła kilkukrotnie problemy z wydajnością funkcji wiadomości WhatsApp i później potwierdziła przywrócenie problemu o godzinie 16:56 UTC.
Pewna funkcja może zostać uszkodzona, podczas gdy reszta CRM pozostanie użyteczna.
Incydenty z 10 czerwca ujawniają dwa różne poziomy awarii
10 czerwca jest szczególnie ważny, ponieważ „awaria Salesforce” może oznaczać więcej niż jedno zdarzenie. Rekord zaufania Salesforce opisał awarie uwierzytelniania wieloskładnikowego w kilku chmurach. Późniejszy raport działań naprawczych Heroku opisał przerwę w działaniu platformy, która rozpoczęła się o godzinie 06:00 UTC i była spowodowana niezamierzoną aktualizacją systemu wprowadzoną do infrastruktury produkcyjnej przez dostawcę.
Firma Heroku przyznała również, że jej strona ze statusem została dotknięta problemem. Zgodnie z aktualizacją działań naprawczych Heroku , wady projektowe strony ze statusem i opóźnienia API doprowadziły do przekroczenia limitu czasu, a strona mogła pozornie nie wskazywać żadnych aktywnych incydentów. Firma Heroku poinformowała, że zareagowała, wprowadzając środki kontroli, takie jak trwałe wstrzymanie nienadzorowanych aktualizacji systemów operacyjnych dostawców, audyty obrazów, dodatkowy monitoring, buforowaną zawartość statusu, niezależne planowanie komunikacji oraz bardziej rygorystyczne procedury reagowania na incydenty.
To cenne rozróżnienie dla administratorów. Strona statusu nie jest usługą samą w sobie, ale klienci korzystają z niej, aby zdecydować, czy poczekać, przełączyć się na tryb awaryjny, zgłosić problem z pomocą techniczną, czy skontaktować się z własnymi użytkownikami. Jeśli kanał statusu współdzieli zbyt wiele elementów infrastruktury z platformą, której dotyczy problem, może nie zapewniać wiarygodnego widoku w momencie, gdy jest on najbardziej potrzebny.
Czego nauczył klientów Salesforce rekord z 2025 r.?
1. Uwierzytelnianie zasługuje na własny plan ciągłości
Zespół może mieć prawidłowe dane aplikacji, ale nadal nie być w stanie pracować, jeśli logowanie, uwierzytelnianie wieloskładnikowe lub połączona ścieżka tożsamości zawiedzie. Jest to szczególnie ważne dla firm, które korzystają jednocześnie z Salesforce, Heroku, Commerce i Marketing Cloud. Należy udokumentować, którzy użytkownicy potrzebują dostępu do poszczególnych systemów, wskazać osoby kontaktowe w nagłych wypadkach, które mogą otrzymywać aktualizacje od dostawców, oraz określić, jakie prace mogą być kontynuowane bez pomyślnego logowania.
Dla małego zespołu sprzedaży może to oznaczać krótkotrwałą, ręczną listę połączeń i wspólny dziennik incydentów. W przypadku contact center lub placówki służby zdrowia może to wymagać formalnej procedury przestoju, zatwierdzonych eksportów tylko do odczytu oraz przetestowanego drzewa eskalacji. Skala awarii powinna być adekwatna do konsekwencji biznesowych wynikających z zablokowania dostępu.
2. Ogólna strona statusu nie wystarczy
Własna dokumentacja Salesforce wyjaśnia, że Status Zaufania dostarcza informacji o dostępności i wydajności, podczas gdy nowsze widoki Mojego Centrum Zaufania zostały zaprojektowane z myślą o dzierżawcach i obsługiwanych produktach. Zasada działania jest prosta: poznaj identyfikator swojej instancji lub dzierżawcy przed wystąpieniem incydentu.
Salesforce udostępnia również instrukcje dotyczące subskrybowania wiadomości i powiadomień w Moim Centrum Zaufania . Skonfiguruj powiadomienia dla osób, które muszą działać, a nie tylko dla administratora, który pierwotnie utworzył organizację. Utrzymuj niezależny kanał, taki jak wewnętrzna strona statusu lub zatwierdzona grupa wiadomości, aby Twoja firma mogła się komunikować, nawet jeśli strona statusu dostawcy jest powolna lub niedostępna.
3. Odzyskiwanie to coś więcej niż tylko zobaczenie ekranu logowania
Gdy Salesforce zgłosi przywrócenie usług, incydent może nadal mieć wpływ na działalność firmy. Opóźnione żądanie API może zostać ponowione dwukrotnie, wiadomość w kolejce może dotrzeć z opóźnieniem, a nieudane wdrożenie może spowodować brak synchronizacji rekordów. Po odzyskaniu danych sprawdź najważniejsze przepływy pracy: uwierzytelnianie, wywołania API, zaplanowane zadania, kolejki integracji, dostarczanie wiadomości e-mail lub komunikatów, tworzenie rekordów i aktualność raportów.
Wyobraźmy sobie na przykład średniej wielkości zespół wsparcia, którego agenci korzystają ze zgłoszeń Salesforce, a oddzielny system handlowy wysyła aktualizacje poprzez integrację. Jeśli Salesforce stanie się dostępny o 10:00 rano, ale kolejka integracji zawiera nieudane komunikaty z okna awarii, zespół nie powinien zamykać zgłoszenia tylko dlatego, że przeglądarka się załadowała. Prawidłowym testem jest sprawdzenie, czy nowe i wcześniej nieudane aktualizacje zgłoszeń przechodzą przez cały proces bez duplikowania.
Jakie środki zapewnienia ciągłości działania są odpowiednie dla Twojej organizacji?
Kondycja firmy
Minimum praktyczne
Kiedy dodać więcej
Mały zespół; krótka przerwa jest do zniesienia
Subskrybuj istotne powiadomienia Trust, zapisz identyfikator wystąpienia i prowadź krótką listę kontrolną prac ręcznych.
Dodaj testy eksportu i odzyskiwania, jeśli historia klienta lub zapisy zgodności mają kluczowe znaczenie.
Przychody, obsługa centrum kontaktowego lub operacje serwisowe zależą od Salesforce przez cały dzień
Korzystaj z niezależnego monitorowania, procedury przestoju, kontroli ponawiania prób integracji i wyznaczonego właściciela incydentu.
Przetestuj awaryjne zasilanie lub alternatywne kanały dopływowe w godzinach pracy przed wystąpieniem rzeczywistej awarii.
Salesforce jest połączony z Heroku lub kilkoma chmurami
Monitoruj oddzielnie źródła statusu każdego produktu i zależności uwierzytelniania dokumentów.
Przeprowadzaj wspólne ćwiczenia odzyskiwania danych, które pozwolą na wspólne testowanie logowania, interfejsów API, kolejek i komunikacji z klientami.
Dane regulowane lub o wysokiej wartości
Korzystaj z zatwierdzonego projektu tworzenia kopii zapasowych i przechowywania danych, kontroli dostępu, ścieżek audytu i podręcznika odzyskiwania danych.
Zleć przegląd podręcznika działom bezpieczeństwa, prawnym, zgodności z przepisami i właścicielom biznesowym.
Jak korzystać z tej retrospektywy w roku 2026 i później
Zacznij od jednostronicowej mapy zależności. Zapisz swoją instancję Salesforce lub tenanta, dostawcę tożsamości, połączone chmury, krytyczne integracje, status subskrypcji oraz proces ręczny zastosowany podczas awarii. Następnie zdefiniuj obiektywne sprawdzenie odzyskiwania dla każdego ważnego przepływu pracy. Stwierdzenie „Salesforce powrócił” jest zbyt ogólnikowe; stwierdzenie „nowe zgłoszenia, wiadomości wychodzące i aktualizacje zamówień są przetwarzane bez duplikatów” jest możliwe do sprawdzenia.
Na koniec przejrzyj zmiany, które mogą wpłynąć na dostępność: aktualizacje dostawców, zmiany systemów operacyjnych, wydania, zmiany konfiguracji i migracje instancji. Incydent z czerwcowego incydentu Heroku pokazuje, dlaczego nienadzorowane zmiany wymagają silnych mechanizmów kontroli, a komunikacja o statusie wymaga własnej odporności. Wydarzenie z 18 czerwca pokazuje, dlaczego pojemność fizyczna i zależności od centrum danych nadal mają znaczenie w usłudze chmurowej. Degradacja funkcji w grudniu pokazuje, dlaczego zespoły powinny monitorować funkcje, z których faktycznie korzystają, a nie tylko dostępność platformy na najwyższym poziomie.
Najbardziej odpowiednią reakcją jest zatem reakcja warunkowa. Mała organizacja może potrzebować powiadomień i przejrzystej, ręcznej listy kontrolnej. Firma, która nie może wstrzymać sprzedaży ani wsparcia, potrzebuje niezależnego monitorowania, odzyskiwania danych z uwzględnieniem kolejki i przećwiczonego procesu przestoju. Organizacja o wysokim poziomie regulacji potrzebuje przetestowanego procesu przywracania, dowodów i zarządzania. Historia awarii Salesforce z 2025 roku potwierdza jeden spójny wniosek: odporność opiera się na łańcuchu zależności klienta, a nie na pojedynczym zielonym wskaźniku statusu.
Źródła i zakres
W tej retrospektywie wykorzystano rejestry incydentów zaufania Salesforce oraz dokumentację Salesforce lub Heroku dostępną w momencie pisania. Strony incydentów można aktualizować po ich rozwiązaniu, a zakres produktów Salesforce różni się w zależności od statusu zaufania i Mojego Centrum zaufania. W przypadku, gdy Salesforce nie opublikował szczegółowej analizy przyczyn źródłowych, niniejszy artykuł nie zawiera takiej analizy.