Strona główna
» Technologia
»
Co powoduje powszechne przestoje platformy chmurowej? Schematy awarii leżące u podstaw poważnych awarii
Co powoduje powszechne przestoje platformy chmurowej? Schematy awarii leżące u podstaw poważnych awarii
Powszechne przestoje platform chmurowych rzadko wynikają z awarii pojedynczego serwera. Najbardziej destrukcyjne incydenty zazwyczaj zaczynają się od jednej usterki technicznej – nieprawidłowej konfiguracji, usterki oprogramowania, problemu z DNS, awarii sieci lub zdarzenia związanego z infrastrukturą – a następnie rozprzestrzeniają się, ponieważ wiele usług jest zależnych od tych samych płaszczyzn sterowania, baz danych, systemów tożsamości, modułów równoważenia obciążenia lub zasobów regionalnych.
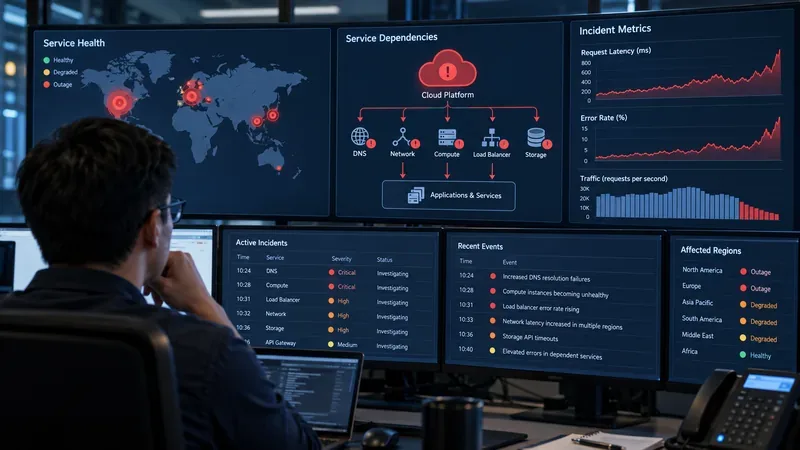
Przykładowy scenariusz: wyobraź sobie fikcyjnego dostawcę usług chmurowych o nazwie Northstar Cloud. O godzinie 10:05 automatyczna zmiana sieci zostaje wprowadzona do usługi regionalnej. W ciągu kilku minut klienci zaczynają zgłaszać nieudane wywołania API. O godzinie 10:12 nowe maszyny wirtualne przestają się uruchamiać. O godzinie 10:20 moduły równoważenia obciążenia zaczynają oznaczać sprawne back-endy jako niedostępne. O godzinie 10:35 dziesiątki pozornie niepowiązanych produktów ulegają degradacji. Ten scenariusz jest hipotetyczny, a nie opisuje rzeczywistej awarii. Jest przydatny, ponieważ pokazuje, dlaczego niewielka awaria inicjująca może przerodzić się w poważne zdarzenie na platformie.
Zespoły odpowiedzialne za operacje w chmurze często muszą śledzić awarię od pierwszego uszkodzonego elementu zależnego, poprzez DNS, sieć, obliczenia, równoważenie obciążenia, pamięć masową i aplikacje podrzędne.
Krótka odpowiedź: poważne awarie chmury zwykle są kaskadowe
Głównymi przyczynami powszechnych przestojów platform chmurowych są błędy konfiguracji i wdrożenia, ukryte wady oprogramowania, awarie DNS i routingu, zależności między usługami współdzielonymi, wyczerpanie pojemności podczas awarii lub odzyskiwania, problemy z płaszczyzną sterowania oraz awarie fizyczne wpływające na centrum danych lub strefę dostępności. Skala awarii zależy mniej od pierwszego błędu, a bardziej od tego, jak szeroko współdzielony jest dany komponent.
Użyteczny przykład z życia wzięty pochodzi z AWS. W oficjalnym podsumowaniu zdarzenia po awarii w październiku 2025 roku w Północnej Wirginii, AWS poinformowało, że utajony wyścig w zautomatyzowanym systemie zarządzania DNS DynamoDB spowodował nieprawidłowy, pusty rekord DNS dla regionalnego punktu końcowego. Ta awaria DNS wpłynęła na klientów i wewnętrzne usługi AWS zależne od DynamoDB, a późniejsze prace naprawcze przyczyniły się do problemów z uruchomieniem EC2 i systemami równoważenia obciążenia sieci. Incydent został udokumentowany w podsumowaniu zdarzenia AWS po awarii w październiku 2025 roku w DynamoDB .
1. Zmiany konfiguracji mogą spowodować nieoczekiwanie duży promień wybuchu
Błędy konfiguracji należą do najczęstszych wzorców w dużych incydentach związanych z systemami rozproszonymi, ponieważ nowoczesne platformy są sterowane za pomocą automatyzacji. Pojedynczą zmianę można przesłać do tysięcy hostów, routerów, rekordów DNS lub punktów końcowych usług szybciej, niż operator mógłby to zrobić ręcznie.
Wróćmy do scenariusza Northstar Cloud. Załóżmy, że zmiana sieci o godzinie 10:05 była przeznaczona dla dziesięciu maszyn, ale została wprowadzona w kilku regionach. Zmiana nie musi niszczyć sprzętu. Może po prostu usunąć użyteczną przepustowość sieci, zmienić routing lub spowodować, że systemy odrzucą normalny ruch. Gdy współdzielona przepustowość spadnie poniżej zapotrzebowania, klienci doświadczają przekroczeń limitu czasu i ponownych prób, co dodatkowo zwiększa obciążenie.
Google opisał podobny mechanizm w swoim oficjalnym raporcie dotyczącym zakłóceń w 2019 roku: zmiana konfiguracji przeznaczona dla niewielkiej liczby serwerów w jednym regionie została błędnie zastosowana w znacznie szerszym zakresie, powodując, że wiele regionów przestało wykorzystywać ponad połowę dostępnej przepustowości sieci. Ruch następnie przeciążył pozostałą przepustowość. Zobacz oficjalną aktualizację Google dotyczącą zakłóceń w świadczeniu usług w 2019 roku .
Dlatego doświadczeni operatorzy chmury stosują etapowe wdrożenia, walidację, automatyczne wycofywanie zmian, limity szybkości zmian i kontrolę „promienia wybuchu”. Te zabezpieczenia nie eliminują incydentów, ale mogą zapobiec przekształceniu się jednej złej zmiany w zdarzenie obejmujące całą platformę.
2. Wady oprogramowania mogą pozostać ukryte do momentu wystąpienia rzadkich warunków czasowych
Duże platformy chmurowe obsługują ogromne floty rozproszonego oprogramowania. Niektóre defekty pozostają uśpione przez miesiące lub lata, ponieważ wymagają rzadkiej sekwencji zdarzeń: dwóch kontrolerów aktualizujących ten sam stan, nietypowego opóźnienia, nieaktualnych metadanych lub procesu odzyskiwania uruchomionego jednocześnie z procesem czyszczenia.
W fikcyjnym incydencie Northstar wyobraź sobie, że dwóch niezależnych pracowników automatyzacji aktualizuje ten sam plan DNS. Jeden z nich jest opóźniony, drugi kończy nową aktualizację, a następnie procedura czyszczenia usuwa dane, które opóźniony pracownik właśnie uaktywnił. Każdy z komponentów może wydawać się działać zgodnie z przeznaczeniem, ale ich interakcja powoduje nieprawidłowy stan.
Wydarzenie AWS DynamoDB z 2025 roku wyraźnie ilustruje tę kategorię. AWS przypisał inicjującą awarię utajonemu wyścigowi między redundantnymi komponentami zarządzania DNS. Znaczenie jest szersze niż tylko jednego dostawcy: redundancja poprawia niezawodność tylko wtedy, gdy redundantne komponenty nie mogą uszkodzić współdzielonego stanu przez tę samą logikę lub awarię synchronizacji.
3. Awarie DNS i sieci mogą spowodować, że sprawne systemy staną się niedostępne
Usługa może być w pełni włączona, a mimo to być praktycznie niedostępna, jeśli klienci nie mogą rozwiązać jej nazwy hosta lub pakiety nie mogą do niej dotrzeć. DNS, routing, równoważenie obciążenia i konfiguracja sieci znajdują się zatem na ścieżce krytycznej dla niemal każdego produktu chmurowego.
W naszym przykładzie Northstar klienci mogliby założyć, że sama usługa obliczeniowa uległa awarii, ponieważ wywołania API przekroczyły limit czasu. Jednak rzeczywiste serwery obliczeniowe mogą być sprawne, podczas gdy DNS nie zwraca użytecznego punktu końcowego, brakuje trasy lub moduł równoważenia obciążenia usunął sprawne cele.
AWS udokumentował ten tryb awarii więcej niż jeden raz. W przypadku incydentu w regionie Seulu w 2018 roku, AWS poinformował, że aktualizacja konfiguracji nieprawidłowo usunęła ustawienie określające minimalną liczbę sprawnych hostów dla floty resolverów DNS EC2. Zmniejszona przepustowość resolverów spowodowała następnie niepowodzenie zapytań DNS z instancji EC2. Szczegóły znajdują się w podsumowaniu AWS dotyczącym problemu z rozpoznawaniem nazw DNS EC2 w Seulu w 2018 roku .
Awarie sieciowe również szybko się nasilają, ponieważ aplikacje ponawiają próby nawiązania nieudanych połączeń. Agresywne próby ponawiania połączeń mogą przekształcić częściowe uszkodzenie sieci w znacznie większy wzrost ruchu.
4. Współdzielone zależności powodują awarię niezależnych usług
Usługi w chmurze nie są produktami izolowanymi. Zarządzana baza danych może być zależna od usług tożsamości, wewnętrznego DNS, pamięci masowej, sieci, systemów harmonogramowania, usług certyfikatów i telemetrii. Platforma bezserwerowa może być zależna od mocy obliczeniowej, sieci, kolejkowania i baz danych płaszczyzny sterowania. Jeśli jedna współdzielona zależność ulegnie awarii, wiele produktów może przestać działać jednocześnie.
To wyjaśnia jeden z najbardziej mylących objawów awarii: klienci widzą błędy w kilku usługach i zakładają, że wystąpiło kilka niezależnych awarii. W rzeczywistości wszystkie widoczne awarie mogą mieć tę samą przyczynę.
W scenariuszu Northstar usługa maszyny wirtualnej, usługa kontenerowa i usługa bezserwerowa mogą zacząć zawodzić, ponieważ opierają się na tej samej wewnętrznej bazie danych zasobów. Produkty przeznaczone dla klientów różnią się, ale zależności między nimi są różne.
Incydent w AWS z października 2025 r. pokazał tego typu kaskadę, gdy wewnętrzne usługi oparte na DynamoDB zostały dotknięte pierwotnym problemem DNS, po którym nastąpiły dalsze efekty odzyskiwania w EC2, Network Load Balancer, Lambda, usługach kontenerowych, funkcjach związanych z tożsamością i innych produktach.
5. Odzyskiwanie może się nie powieść, ponieważ zaległości są większe niż normalne obciążenie operacyjne
Przywrócenie oryginalnego, uszkodzonego komponentu nie zawsze kończy awarię. Podczas przestoju kolejki rosną, dzierżawy wygasają, kontrole stanu kończą się niepowodzeniem, autoskalery żądają wymiany pojemności, klienci ponawiają żądania, a aktualizacje konfiguracji kumulują się. Po powrocie uszkodzonej zależności, wszystkie oczekujące systemy mogą jednocześnie podjąć próbę odzyskania.
W przykładzie Northstar załóżmy, że DNS został naprawiony o 10:45. Tysiące hostów obliczeniowych próbuje teraz odnowić wygasłe dzierżawy. Jednocześnie klienci ponawiają próby nieudanych wdrożeń, a systemy automatycznego skalowania żądają instancji zastępczych. Płaszczyzna sterowania nagle przetwarza obciążenie wielokrotnie przekraczające normalne. Jeśli nie ma efektywnych limitów przepustowości ani priorytetów odzyskiwania, może przejść w drugi tryb awarii, mimo że pierwotny błąd zniknął.
AWS opisał podobny problem odzyskiwania danych w 2025 roku: po przywróceniu dostępu do DynamoDB podsystem EC2 musiał ponownie ustanowić dużą liczbę dzierżaw. Zaległości stały się trudne do przetworzenia przed przekroczeniem limitu czasu, a AWS poinformował, że podsystem wszedł w stan „zastoju z powodu przeciążenia”. Ten szczegół jest istotny, ponieważ pokazuje, dlaczego czas trwania awarii może być znacznie dłuższy niż czas potrzebny na naprawienie pierwotnego czynnika wyzwalającego.
6. Kontrole stanu i automatyczne przełączanie awaryjne mogą czasami powodować utratę dobrej wydajności
Kontrole stanu sieci są niezbędne, ale pełnią również funkcję automatycznych decydentów. Jeśli sieć działa wolno lub propagacja stanu jest opóźniona, system kontroli stanu może stwierdzić, że sprawne zasoby są uszkodzone i wyłączyć je z użytku. Może to dodatkowo zmniejszyć przepustowość, tworząc pętlę sprzężenia zwrotnego.
W fikcyjnym scenariuszu moduły równoważenia obciążenia Northstar rozpoczynają sprawdzanie nowo uruchomionych instancji, zanim konfiguracja sieciowa zostanie w pełni rozpropagowana. Kontrole kończą się niepowodzeniem, sprawne instancje są wycofywane, ruch jest przekierowywany do mniejszej liczby pozostałych węzłów, a te z kolei zostają przeciążone.
Ten schemat pojawił się również podczas wydarzenia AWS w 2025 roku. AWS poinformował, że kontrole stanu modułu równoważenia obciążenia sieci (Network Load Balancer) czasami kończyły się niepowodzeniem, gdy stan sieci dla nowych instancji był nadal propagowany, co prowadziło do wyłączenia zasobów z eksploatacji. Przypomina to, że logika przełączania awaryjnego musi być ograniczona przepustowością i testowana w warunkach częściowej awarii, a nie tylko w czystych warunkach „zdrowych/niezdrowych”.
7. Nadal możliwe są awarie centrów danych, zasilania, chłodzenia i stref dostępności
Nie każda awaria ma swój początek w oprogramowaniu. Zasilanie, chłodzenie, światłowody, sprzęt sieciowy i inna infrastruktura fizyczna mogą ulec awarii. Architektura chmurowa została zaprojektowana z uwzględnieniem tej rzeczywistości, dlatego główni dostawcy dzielą regiony na strefy izolowane od awarii.
Microsoft wyjaśnia, że strefy dostępności platformy Azure to oddzielne grupy centrów danych z niezależnym zasilaniem, chłodzeniem i siecią. Microsoft zauważa również, że wdrożenie strefowe nie jest automatycznie odporne na awarię strefy; klienci muszą korzystać z wielu stref lub usług z redundancją strefową, jeśli jest to obsługiwane. Zobacz oficjalny przegląd stref dostępności platformy Azure firmy Microsoft .
W praktyce dostawca usług w chmurze może uczynić strefę niezależną, ale obciążenie klienta nadal może mieć bazę danych w pojedynczej strefie, pojedynczą zależność kontroli regionalnej lub proces przełączania awaryjnego, który nigdy nie został przetestowany.
Dlaczego awaria chmury może wydawać się globalna, nawet jeśli jej przyczyna ma charakter regionalny
„Globalna awaria” często opisuje wpływ na klienta, a nie fizyczną lokalizację uszkodzonego sprzętu. Usługa regionalna może obsługiwać uwierzytelnianie, DNS, metadane, potoki kompilacji, pulpity nawigacyjne lub interfejsy API sterowania używane w innych regionach. Aplikacje na całym świecie mogą zatem ulec awarii, ponieważ są zależne od usługi skoncentrowanej w jednej lokalizacji.
To rozróżnienie ma znaczenie przy diagnozowaniu incydentu. Inżynierowie powinni zadać sobie dwa pytania: Gdzie wystąpiła pierwsza awaria? Oraz Które zależności umożliwiły rozprzestrzenienie się tej awarii? Odpowiedzi na te pytania często się różnią.
Jak zidentyfikować prawdopodobną przyczynę zdarzenia na żywo
Dla operatorów najszybszą drogą jest zazwyczaj korelacja objawów, a nie badanie każdego produktu osobno. Jeśli wiele usług ulega awarii w tym samym momencie, należy poszukać współzależności. Jeśli istniejące obciążenia działają prawidłowo, podczas gdy nowe wdrożenia zawodzą, należy podejrzewać problem z płaszczyzną sterowania, harmonogramem, przepustowością lub provisionowaniem. Jeśli łączność IP działa, ale nazwy usług zawodzą, należy zbadać DNS. Jeśli po ogłoszeniu odzyskiwania wzrośnie liczba błędów, należy poszukać burz ponownych prób, zaległości, wygasłych dzierżaw, pętli sprzężenia zwrotnego kontroli stanu lub niewystarczającej wydajności odzyskiwania.
Systemy statusu dostawców mogą również pomóc odróżnić incydent platformy od błędu specyficznego dla aplikacji. Na przykład Google Cloud publikuje bieżące i historyczne incydenty za pośrednictwem oficjalnego panelu Service Health , podczas gdy AWS publikuje podsumowania najważniejszych zdarzeń za pośrednictwem oficjalnych podsumowań po zdarzeniu .
Co mogą zrobić klienci, aby zmniejszyć wpływ
Żadna architektura nie gwarantuje zerowego przestoju, ale kilka rozwiązań projektowych ogranicza ryzyko. Używaj wielu stref dostępności dla obciążeń produkcyjnych, gdy usługa je obsługuje. W przypadku obciążeń, które nie tolerują regionalnej awarii, przeanalizuj projekty wieloregionalne i poznaj kompromisy dotyczące spójności danych. Wyeliminuj ukryte pojedyncze punkty awarii, takie jak jedna regionalna usługa tożsamości, jedna ścieżka DNS lub jeden administracyjny interfejs API, od których zależy każda akcja odzyskiwania.
Aplikacje powinny również poprawnie reagować na awarie. Może to oznaczać obsługę zawartości buforowanej, kolejkowanie niekrytycznych zapisów, ograniczanie liczby ponownych prób za pomocą wykładniczego odczekiwania i jittera, oddzielenie operacji na płaszczyźnie sterowania od ruchu na płaszczyźnie danych oraz zachowanie zredukowanego trybu „tylko do odczytu” lub „transakcji podstawowej” podczas częściowych awarii. Procedury odzyskiwania powinny być testowane w warunkach zaległości, ponieważ ponowne uruchomienie zależności w pustym środowisku testowym znacznie różni się od przywrócenia jej, gdy miliony żądań oczekują.
Kluczowa lekcja płynąca z powszechnych przestojów w chmurze
Wróćmy do scenariusza Northstar Cloud. Zmiana konfiguracji o 10:05 może być przyczyną, ale nie stanowi pełnego wyjaśnienia. Awaria staje się powszechna, ponieważ sieć jest współdzielona, automatyzacja ma wadę czasową, usługi downstream zależą od tego samego stanu, kontrole stanu zmniejszają pojemność, ponowne próby zwiększają obciążenie, a systemy odzyskiwania muszą przetwarzać ogromne zaległości.
To jest główny schemat leżący u podstaw wielu poważnych incydentów w chmurze: awaria inicjująca jest często niewielka w porównaniu z łańcuchem zależności, który ją wzmacnia. Zrozumienie przestoju w chmurze oznacza zatem zbadanie zarówno pierwotnej przyczyny, jak i propagacji. Najbardziej odporne projekty zakładają, że poszczególne komponenty ulegną awarii i koncentrują się na zapobieganiu przekształcaniu się tych awarii w zdarzenia w całym systemie.